В контрольной группе оказался покупатель с заказом на пять тысяч рублей. В тестовой таких заказов не было, и новый вариант проиграл по выручке на участника. При ограничении крупных сумм разница средних между тестовой и контрольной группами становится положительной. Прежде чем выбирать более приятный результат, нужно выяснить происхождение покупки и назвать показатель, который команда собирается оценивать.
AI-агент увидел дневной лимит 1000 рублей и подготовил повышение до 1200. Пока он составлял запрос, медиабайер снизил лимит до 800. Простая запись агента затрёт более новое решение. Проверка версии при сохранении позволяет остановить такую команду и заново разобрать её смысл.
Расходы магазина выгрузили отдельно от продаж и связали таблицы по артикулу. В итоговой ведомости остались только товары, которые нашли совпадение. Реклама без покупки исчезла вместе с расходом, и результат стал выглядеть лучше. Перед расчётом эффективности нужно сохранить исходную расходную базу и отдельно проверить полноту продаж.
В двух файлах один адрес выглядит почти одинаково. В одном есть заглавная буква и пробелы по краям, в другом только строчные символы. Если сразу посчитать SHA-256, результаты разойдутся. Командам нужно согласовать алгоритм и точный порядок подготовки исходной строки.
Поставщик говорит, что фильтр ошибочно помечает лишь один процент нормальных показов. Это не означает, что 99% его флагов верны. Если нарушения редки, ложных флагов может оказаться больше, чем верных, даже при небольшой доле ложных тревог. Для решения об исключении трафика нужны оба знаменателя и проверенная разметка.
По двум размещениям объявления стали получать клики чаще. В общем отчёте кликабельность при этом снизилась втрое. Прежде чем менять креатив или обвинять алгоритм, проверьте, как перераспределились показы. Общий результат зависит от качества каждой части и от её веса в закупке.
После запуска нового интерфейса люди чаще нажимают на рекламу. Через неделю разница уменьшается. Это может быть привыканием, изменением состава посетителей или обычным шумом. Первую удачную неделю нельзя автоматически переносить на весь будущий медиаплан: сначала нужно разобрать, как результат меняется со временем.
Алгоритм выбрал три карточки с максимальными оценками, но все они показывают почти один и тот же товар. Каждая карточка подходит запросу, а список не даёт полезного выбора. Для такой задачи нужно оценивать следующий элемент относительно уже выбранных, сохраняя требования к релевантности и коммерческие ограничения.
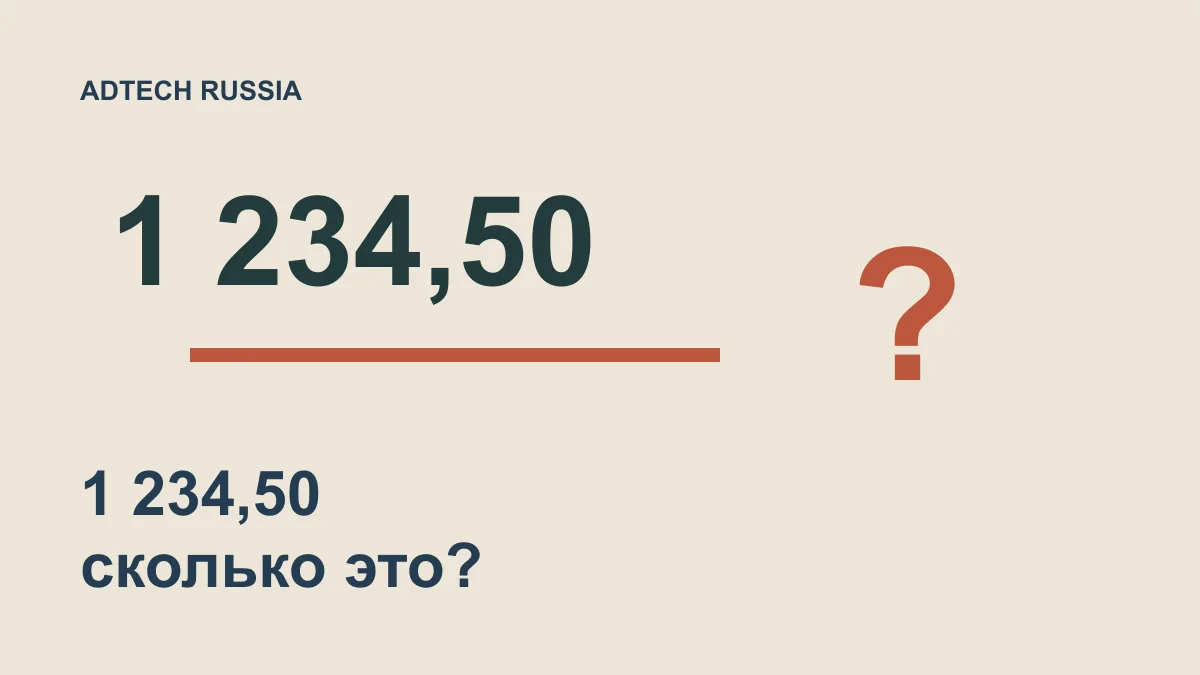
Рекламная выгрузка открылась без ошибки, но сумма расходов стала другой. Причиной может быть не округление, а разбор строки по неподходящим правилам. Десятичная запятая, точка и разделитель тысяч меняют смысл записи. Формат источника нужно задать до преобразования и проверить по контрольным строкам.
Серия «знакомство, объяснение, предложение» выглядит убедительно в презентации. Но если следующий шаг включается после заявки на показ, человек может получить финальное предложение, так и не увидев начало. Нужно определить, когда переходить к следующему креативу и что делать без истории показов.
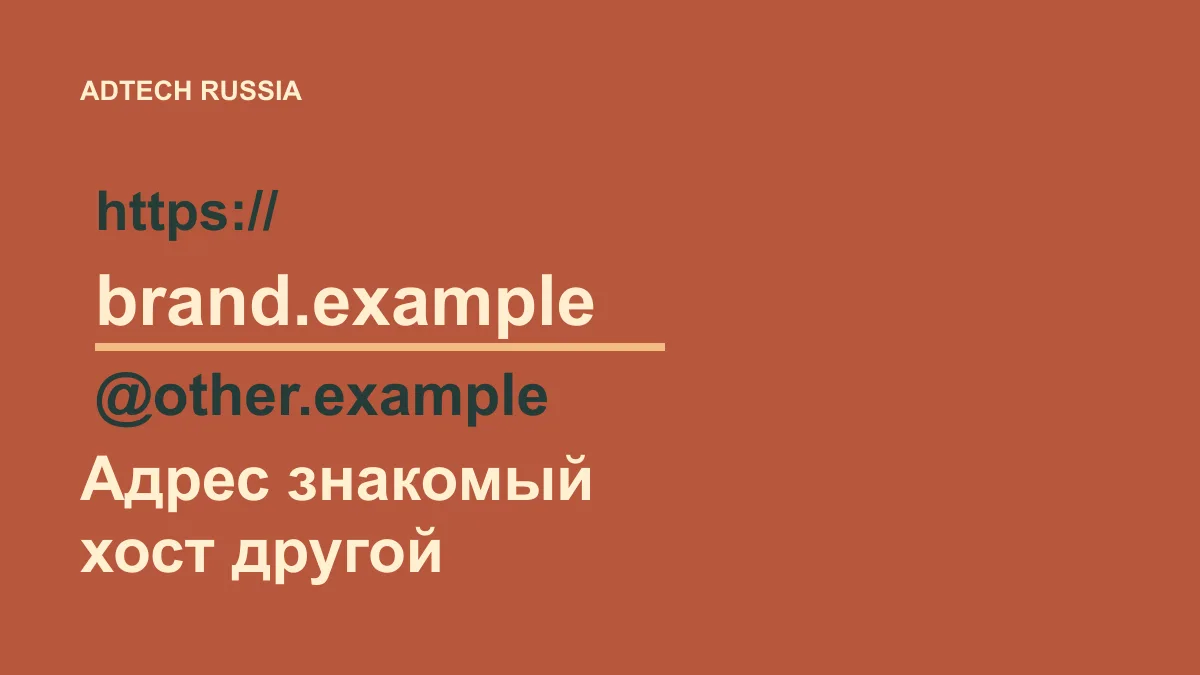
В строке встречается разрешённое имя бренда, и помощник считает адрес безопасным для открытия. Но это имя может оказаться логином, частью пути или параметром. Перед обращением нужно разобрать адрес и проверить именно хост, сохраняя другие ограничения отдельно.
Покупатель уже авторизовался в магазине, но после рекламного перехода снова видит вход. Ссылка может быть правильной: приложение открыло её в другом браузерном контейнере с отдельным хранилищем. Это проверяют отдельно от UTM, карточки товара и открытия приложения.
Агентству удобно дать одному помощнику доступ к медиапланам, отчётам и прошлым решениям. Но сводка для одного бренда не должна опираться на закрытые сведения другого. Проверять нужно документы, историю диалога, поиск, кэш и сохранённые выводы.
В отчёте снова появился нежелательный запрос, хотя исключение добавлено. Или после чистки исчезли покупатели, которым нужен товар с доставкой. Разбираем проверку по одной строке: запрос, ключ, полный набор исключений и ожидаемое решение.
Недавний просмотр лампы не отменяет давнего интереса к рабочему столу. Новая работа Wayfair показывает отбор истории сразу по двум основаниям: что человек ищет сейчас и какой товар система оценивает. Полезный урок для retail media касается выбора сведений, а не бесконечного увеличения памяти.
Товарный фид прошёл проверку длины кода и контрольной цифры, но объявление ведёт на другую упаковку. Арифметическая согласованность GTIN помогает найти ошибки записи. Она не доказывает, что номер присвоен именно этому товару, объёму и комплектации.
Тест показывает значимое различие, хотя обеим группам выдали один вариант. Это повод проверить процедуру, но один такой результат ещё не доказывает неисправность. A/A-тест помогает искать ошибки назначения, сбора данных и статистического анализа при отсутствии запланированного воздействия.
AI-агент скачал все страницы отчёта и уверенно сравнил кампании. Но сервис мог рассчитать сам отчёт только по части исходных наблюдений. Полнота скачивания и полнота статистической основы различаются. Вместе с итогами нужно сохранять фактические параметры выборки.
Две группы случайно получили разные объявления, но результат сильно колеблется из-за привычной активности пользователей. Если до запуска есть подходящая история, её можно использовать для более точной оценки. Метод CUPED требует заранее выбранного признака и проверки того, как он связан с результатом.
В каталоге есть товары 00123 и 123. После открытия файла оба могут оказаться числом 123, и продажи одного товара соединятся с расходами другого. Ключи лучше импортировать как текст и проверять до любых итоговых расчётов.
Источник передал расход 1200, а ниже в том же объекте ещё раз написал 900. Некоторые парсеры сохранят последнее значение. Если проверять только уже собранный объект, след первого поля исчезнет ещё до анализа агентом.
Агент отправил POST и получил ответ с другим адресом. После автоматического перехода вернулся HTTP 200, но это может быть уже результат другого запроса. В приёмке нужно сохранить всю цепочку, включая методы и тела.
Коллега опубликовал рекламную ссылку в сообщении, а сервер уже увидел обращения. Часть могла понадобиться сервису для карточки предпросмотра. Чтобы объяснить расхождение кликов и посещений, нужно разделить сетевой запрос и действие человека.
Баннер может просить страницу открыть панель, изменить высоту или зарегистрировать действие. Перед исполнением нужно проверить отправителя и содержимое команды. В собственной учебной демонстрации можно увидеть, почему одного знакомого названия события для этого мало.
Ночью площадка собрала отчёт, а утром агент получил ошибку при скачивании. Сначала проверьте состояние задания и срок доступа к файлу. Повторная генерация отчёта нужна лишь тогда, когда готового результата действительно нет или он уже удалён.
Три небольших начисления могут дать разные суммы в зависимости от того, когда их округлили. Прежде чем искать пропавшую копейку в рекламном отчёте, запросите исходную точность и правило формирования итога.
Пользователь пришёл с рекламного размещения, а сервер бренда получил только домен площадки. Это может соответствовать политике браузера. Для проверки происхождения перехода отдельно изучают переданный Referer и собственные разрешённые метки ссылки.
Менеджер просит снизить дневной лимит. Агент отправляет команду, а площадка заодно сбрасывает расписание. Чтобы поймать такую ошибку до запуска, проверяйте итоговый запрос и ожидаемое состояние соседних полей. Начать можно с одной вымышленной кампании и нескольких коротких тестов.
Агент попросил снизить дневной лимит, получил подтверждение и сообщил оператору, что работа закончена. Через секунду запрос на чтение ещё показывает прежний лимит. Если агент примет это за отказ и отправит команду повторно, он может создать второе изменение или перезаписать правку коллеги.
Посетитель отказался от рекламной обработки данных, интерфейс подтвердил выбор, а отладчик всё ещё показывает запросы к поставщикам. По одному экрану и одному запросу диагноз поставить трудно. Проверка по всей цепочке показывает, где именно перестали учитывать выбор.
Ритейлер обещает отчёт по продажам в интернете и в магазинах. После кампании выясняется, что продажи из части торговых точек приходят позже закрытия отчёта, а некоторые строки доступны только по запросу. Решение о следующем бюджете приходится принимать по неполному набору. Перед закупкой полезно запросить пример выгрузки и проверить, какие события в ней появятся, на какой срок и кто объяснит пропуски.
Магазин поменял цену в каталоге, а баннер продолжает показывать прежнюю. Интегратор присылает журнал со статусом 304 и считает обмен успешным. Такой ответ помогает использовать уже сохранённую копию. Чтобы проверить цену, нужно пройти маршрут от каталога до конкретного креатива и найти версию, которую использует каждый участник.
В приложении выбран русский интерфейс, зритель включает другую звуковую дорожку, а отчёт о рекламе всё равно показывает русский язык. Причина может быть в том, что отчёт хранит язык интерфейса. Перед закупкой видеоплощадка и агентство должны решить, нужен им язык меню, язык контента из каталога или фактически выбранная дорожка. Это три разные величины.
В журнале закупки стало в три раза больше запросов от продавцов. Команда видит расширение доступного инвентаря, хотя часть запросов может вести к одному и тому же месту на странице. Чтобы оценить изменение, нужно отдельно считать сообщения, пути продажи и подтверждённые возможности размещения. Неизвестные связи нельзя достроить по похожим адресам и времени.
В название товара попала строка с угловыми скобками. Один шаблон показал её как обычный текст, другой сделал часть названия жирной и изменил структуру карточки. Для рекламного каталога это важное различие: поле с названием не должно получать возможность управлять HTML. Сначала нужно определить разрешённый тип содержимого, а затем выбрать способ вставки.
Выгрузка рекламных кампаний корректно разделена запятыми и заключена в кавычки. Но после открытия в таблице одно название превратилось в формулу. Синтаксис CSV и поведение табличной программы - разные проверки. Для машинного обмена и чтения человеком полезно явно определить разные версии экспорта и не скрывать преобразования значений.
В кампании выбрана Москва, IP-отчёт показывает один регион, а доставка заказа оформлена в другой. Команда подозревает ошибку таргетинга или фрод. Но эти поля могут отвечать на разные вопросы: где оценена сеть, каким регионом интересовался человек и куда отправляется товар. До вывода нужно восстановить смысл и источник каждого значения.
Агентство выгрузило расходы за третье ноября, а площадка прислала другую сумму за ту же дату. События могут быть одинаковыми: одна система считает сутки по Москве, другая по UTC. Сверка начинается с точных границ периода и времени каждого события. Названия файла «за вчера» для этого недостаточно.
Агент быстро назвал расход за месяц, но получил только первые строки API-отчёта. Ответ сервера был успешным, таблица выглядела аккуратно, арифметика сошлась. Ошибка появилась раньше сложения: фрагмент данных был принят за весь период. Полноту выгрузки нужно проверять отдельно от качества ответа модели.
Выгрузка содержит пустые результаты двух кампаний. Перед построением графика программа заменяет их нулями, и среднее падает вдвое. Теперь отчёт уверенно описывает отсутствие результата там, где его никто не наблюдал. Чтобы этого не произошло, значение и состояние данных должны храниться отдельно.
Команде нужно объяснить рост расходов, и она отправляет AI-помощнику всю выгрузку. Вместе с суммами туда попадают контакты, свободные комментарии и служебные поля, которые для вопроса не нужны. Удалить адрес из видимой колонки недостаточно, если он остался в заметке или журнале ошибки. Отбор данных должен происходить до передачи.
Ссылка в объявлении содержит UTM, но в аналитике источник не определён. Проверка одной рекламной ссылки не закрывает вопрос: до первого просмотра браузер мог пройти сокращатель, перенаправление и переход к нужной версии сайта. Сохранять нужно всю цепочку адресов.
Магазин исключил покупателя из выбранной кампании, но ночная выгрузка снова включила его в аудиторию. Строка положительного списка обновилась, а запрет остался в другой системе. Проверять нужно итоговое правило допуска и его версии, а не только факт удаления одной строки.
Вариант B показывает лучшую конверсию, но в анализ попало заметно меньше его пользователей. Разница может быть следствием отбора, фильтра или потери событий. Прежде чем выбирать креатив, нужно проверить, какие люди вообще дошли до сравнения и совпадает ли их состав с планом.
Магазин подключил серверную передачу покупок, но оставил прежний браузерный счётчик. Одна оплата теперь приходит двумя путями, а после сетевого сбоя сервер повторяет отправку. Если каждый запрос получает новый идентификатор, отчёт может увидеть несколько результатов. Исправление начинается с устойчивого ключа операции и правила подтверждения оплаты. Удалять все события одного покупателя или надеяться на совпадение суммы опасно: так можно потерять настоящий второй заказ.
После размещения рекламы бот получил больше команд запуска. Это полезный сигнал входа, но среди них могут быть повторные обращения прежних пользователей и повторная доставка одной команды. Чтобы посчитать новых клиентов, нужны история взаимодействий и отдельное подтверждение заказа. Метка в ссылке помогает связать события, однако сама не удостоверяет ни новизну человека, ни продажу, ни дополнительный эффект рекламы.
В понедельник рекламная команда видит четыре заказа, в четверг три. Закупка не изменилась: аналитик начал исключать полный возврат, но оставил прежнее название показателя. В отчёте это выглядит как потеря продажи. Рабочий словарь данных помогает избежать такой ситуации: он связывает название с точным правилом, владельцем и версией. Разберём заполненный учебный пример для российского интернет-магазина и переход к новому определению без подмены старых отчётов.
Кампания продолжает расходовать бюджет, хотя клиентский признак перестал приходить. Это может означать работающий запасной сценарий, расширение аудитории или ошибку, при которой неизвестное значение принимают за подходящее. Проверку начинают на фиксированных тестовых входах без расходования денег. Лишь после этого имеет смысл изучать результат на ограниченном реальном трафике.
Покупка произошла в магазине, но в рекламном отчёте появляется только тогда, когда её удалось связать с доступным идентификатором. Эта часть покупателей может отличаться от остальных даже при безошибочных совпадениях. На учебном примере покажем, почему общая доля сопоставления не позволяет автоматически восстановить все продажи и какие разрезы нужны аналитику.
Файл из CRM содержит десять тысяч строк, но это ещё не десять тысяч клиентов, которым можно показать рекламу. Сначала нужно определить задачу, удалить повторения, проверить допустимость использования и подготовить подходящие идентификаторы. Даже успешно принятый файл не подтверждает доступный рекламный охват.
Система нашла двадцать тысяч общих покупателей в базах двух ритейлеров. Чтобы использовать число в медиаплане, нужно знать, кого загрузили, по каким ключам связали и сколько покупателей остались вне сопоставления. Защищённая среда не превращает частичное наблюдение в знание всей аудитории.
Страница про сверление стены и материал о медицинской процедуре могут содержать похожее слово, но предлагать читателю разный контекст. Проверка контекстной модели начинается с независимо размеченных страниц и понятных категорий. Общая «точность 95%» без состава выборки мало помогает медиапланеру.
Модель маркетинг-микса показывает высокую отдачу канала, а эксперимент видит слабый эффект. Иногда методы ошибаются, иногда отвечают на разные вопросы. Начните с периода, аудитории и сценария сравнения: усреднение несовместимых оценок не делает их точнее.
Рекламные системы начинают сходиться в цифрах, когда команда одинаково определяет событие, время его учёта и правила исправления. Ниже заполненный пример такого соглашения: его можно передать аналитику, агентству и поставщику до запуска кампании.
Название «готовы купить автомобиль» не объясняет, что известно о людях в сегменте. Они искали машину, читали обзор или просто похожи на прежних покупателей по расчёту модели. До покупки данных нужен паспорт происхождения, который позволяет восстановить этот путь и проверить допустимое использование.
Совместный анализ данных магазина и рекламодателя теряет смысл, если на выходе нельзя получить ответ. Но и таблица без имён способна раскрыть малую группу. Разбираем правила выгрузки на учебном отчёте с покупателями.
Средняя частота кампании не объясняет, сколько стоит следующий новый контакт. На учебном накопленном отчёте считаем прирост охвата, его цену и ограничения, из-за которых этот расчёт легко прочитать неправильно.
Миллион покупателей в базе ритейлера не превращается автоматически в миллион охваченных людей на внешних площадках. Разбираем последовательность проверок offsite retail media и показываем, какие числа нельзя складывать в одну воронку.
В базе 50 тысяч контактов, но среди них заявки без покупки, отменённые заказы и клиенты другой товарной категории. Система добросовестно найдёт похожих на эту смесь людей. Для проверки look-alike сначала нужно определить нужного покупателя и подготовить исходную группу, а затем сравнивать оплаченный результат при одинаковых условиях.
В магазине товар уже нельзя заказать, но объявление продолжает приводить людей на его карточку. Отметка «в наличии» в рекламном кабинете могла прийти из старой версии каталога или относиться к другому складу. Разбираем, как измерить задержку остановки и определить ответственного за каждое звено.
Платформа готова подключиться по API, лицензия согласована, но запуск откладывается. Оказалось, что команда по-разному считает конверсию, не подготовила данные и не определила, кто будет разбирать ошибки после старта. Разбираем смету работ вокруг подключения и условия, по которым можно принять интеграцию.
В одном сегменте сто тысяч записей, в другом восемьдесят. Вместе это ещё не сто восемьдесят тысяч уникальных записей: часть аудитории может находиться в обоих списках. Покажем, как посчитать объединение, сколько второй сегмент добавит к первому и почему пустая ячейка отчёта не всегда означает ноль.
Вчерашняя кампания может выглядеть дороже недельной просто потому, что её покупки ещё не созрели или не дошли из CRM. Сравнивать нужно когорты одинакового возраста, отдельно контролируя время до покупки и время передачи события. Изменение ставок по незавершённому результату способно закрепить ложный вывод о качестве трафика.
Match rate показывает, для какой доли исходных записей система нашла связь по своему определению. Он не сообщает автоматически, что каждая связь относится к нужному человеку. Для приёмки identity-данных нужно отдельно проверить знаменатель, уровень идентификации и точность на разрешённой размеченной выборке.
Дата последнего обновления сегмента не говорит, когда человек проявил интерес к товару. Сегодняшняя выгрузка может содержать старые события, а свежий идентификатор может относиться к уже завершённой покупке. Для проверки таргетинга нужно разделить возраст сигнала, задержку доставки и срок сохранения пользователя в сегменте.
Исследование о first-party data, clean rooms, PAIR, ADMaP, confidential matching и новой логике измерения, где privacy, AI и fragmented signals требуют не нового ID, а новой операционной дисциплины.
Партнерство Out There Media и Pulse показывает модель, где телеком-данные, локальная экспертиза и mobile-first поведение собираются в рекламную инфраструктуру.